摘要:给 Electron 桌面数字人 AI 老师加摄像头视觉的完整落地:浏览器 getUserMedia 取景、canvas 快门压到 768px 约 20KB、拍完立刻释放摄像头、照片 base64 随聊天直达多模态大模型,看图回复照常走 TTS 与口型。含关键取舍(单次抓拍优于实时流)、热开关三层降级实测、接口/引擎直调/CDP 真实点击三层验证,和六条可直接抄的经验。
一、需求拆开:看见 → 看懂 → 开口示范
学员场景很具体:桌上有个不认识的小物件,想问 AI 老师”这是什么,用英语怎么说”。拆下来是三种能力:
- 看见——采集摄像头画面。老师是本地 Electron 桌面应用,Chromium 内核自带
getUserMedia,不需要接 OpenCV、不需要装采集服务,这是后面一切简单的前提。 - 看懂——把画面交给视觉模型。我们用的对话模型本身就是多模态的,能直接吃
data:image/jpeg;base64,…,不需要单独部署一个视觉服务。 - 开口——看图产出的英语描述,要照常进 TTS 合成和数字人口型动画,学员要能”听见老师看着实物说话”。
一个关键取舍:做单次抓拍,不做实时视频流。 实时流意味着每帧都推理,费用、延迟、排队全部爆炸,而且”这个用英语怎么说”的教学场景根本不需要每秒十帧的凝视。取景时开预览、按下快门取一帧、立刻 stop 所有 track 释放摄像头——指示灯熄灭,学员不会对着一个亮着录制灯的老师紧张。这一条是整个方案里最省成本的决策。
二、数据流:一张 20KB 照片怎么穿过三层进程
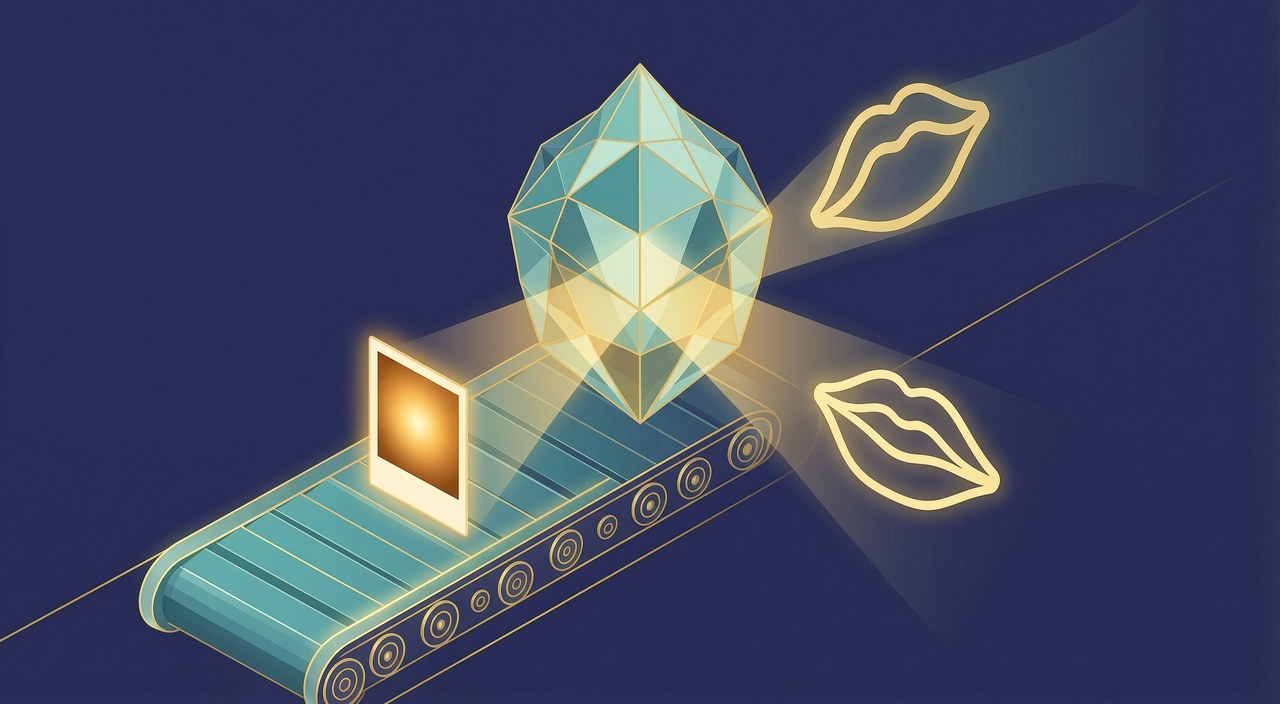
桌面老师是三个进程协作:Electron 渲染层(UI 与摄像头)→ 本地 FastAPI 后端(配置/历史)→ 数字人引擎(LLM + TTS + 口型)。照片的旅程:
📷按钮 → getUserMedia 预览(多摄像头下拉可选)
      → 📸快门: canvas 缩放至长边768px, JPEG q0.85 (实测 20~150KB)
      → stop tracks 释放摄像头 → 审阅小图(可重拍/可只发图不配文)
      → POST /human {text:"What's this?", image:"data:image/jpeg;base64,..."}
      → 引擎 llm_response: 组装多模态 messages 发给大模型
      → 回复文字 → TTS → 数字人口型播出
两个细节值得抄:
- 记忆层不存 base64。 会话历史里这张照片只记一个文字标记”[学生发来一张照片]”。多模态消息只在当前请求的 messages 数组里带图,下一轮历史拼回去时自动退化成纯文本。不这么做的话,历史窗口几十轮就被一张几百 KB 的图撑爆。
- 载荷封顶。 后端对 image 字段做类型白名单(jpeg/png/webp)+ 4MB base64 上限校验,超了静默丢弃降级为纯文本,而不是让一个 10MB 的截图把整条链路拖死。
三、热开关与降级:一个复选框关掉整条视觉链路
上线的视觉功能必须随时能关。配置里加 vision_enabled(总开关)和 vision_model(看图专用模型,留空=复用对话模型),三个读取点:
- UI 提交前读配置,关了就不弹取景窗;
- 后端
/chat、/chat_stream带图请求进来先查开关,关了直接把 img 置 None; - 数字人引擎的 LLM 模块每 30 秒缓存读一次配置文件,关了带图请求自动降级为”文字转述”路径。
实测降级行为正确:vision_enabled=false 时发”Describe what you see”,模型老实承认看不到——因为图真的没送上去,而不是模型幻觉出一句”我看到一张桌子”。这比任何免责声明都可靠。另外留了一个环境变量硬闸(置 1 强制关视觉),应急时不用改配置文件。
四、三层验证:接口、引擎、真实点击
改完代码不能只跑语法检查。按”离真实用户越来越近”分三层:
- L1 后端接口:直接 POST
/chat带一张实拍照片(对着自己的桌面拍),断言回复包含画面里真实存在的物体词。通过:模型描述了台灯、马克杯、键盘,还按教学提示词补了例句。 - L2 引擎直调:不走 HTTP,进程内直接调用引擎的 LLM 函数(mock 一个 session 对象收集句子),验证数字人主链路的看图分支。这层抓到一个真问题:引擎的 LLM provider 默认值指向另一个端点,mock 参数没带 provider 就 401——生产命令行里带着正确参数所以没事,测试脚手架必须复刻生产参数,不然测的是空气。
- L3 CDP 端到端:给 Electron 开
--remote-debugging-port,用 websocket 连上老师窗口的页面,模拟学员完整操作:点 📷 → 等预览出画面 → 点 📸 → 断言摄像头已释放(video 的 srcObject 置空且 stream.getTracks() 全 ended)→ 填问题 → 点发送。
L3 还踩了一个观察点:浮层字幕 8 秒自动淡出销毁,轮询 DOM 抓回复必然漏。改用后端 /history 作为权威通道轮询新回合,才稳稳收到老师的看图英语示范。截图存档见验证日志——模型甚至指出了”房间光线偏暗”,这是真实看见而非套话的证据。
五、可以直接抄走的六条经验
- 单次抓拍优于实时流:教学问答场景一帧就够,省掉排队、费用和隐私压力;快门即释放摄像头,指示灯不常亮。
- Electron 自带浏览器媒体能力:先确认运行环境再引入重型依赖,Chromium 的 getUserMedia + canvas 就是最轻的采集管线。
- 历史只存文字标记,当前请求才带图:多模态进对话轮,不进持久记忆窗口。
- 开关要装在链路的每一层,且降级路径要实测”真的不看图”,防模型幻觉性自信。
- 验证分层:接口层、引擎直调层、CDP 真实点击层;端到端断言用后端历史接口当权威通道,别抓会淡出的瞬时 DOM。
- 测试脚手架复刻生产参数(模型端点、provider、鉴权),否则 401/超时全是假故障,真 bug 反而被噪声盖住。
(完)