摘要:给 AI 获客引擎装上搜索的眼睛:Brave + Kimi 双搜索腿配置全过程实录——注册取 key、Node fetch DNS 污染坑、Moonshot 文档参数名骗人、双腿并行去重架构,同条款 A/B 实测纯 LLM found=0 → 单腿 3 → 双腿 9 且零幻觉。附出海赋能四角度与五个真实短板的升级路线。
引子:当大模型开始“睁眼说瞎话”
我们的 B2B 出海获客控制台(AI 智能体驱动的 ICP→线索→富集→触达流水线)上线后,跑过一个耐人寻味的案例:让智能体寻找“欧盟地区从中国进口家具的经销商/进口商”,纯大模型种子的结果是——
found: 0。一家都没找到。
更魔幻的是过程中:模型一本正经地“编”出了三个不存在的公司域名,幸而被我们加的 DNS 预检闸门当场击毙,没让它们混进数据库。这就是 LLM 的“白眼界”:它的全部知识都冻结在训练数据里,你可以靠它当“业务顾问”(判断一家公司符不符合进口商画像,它比人快一万倍),但你不能靠它当“黄页”——长尾的、区域性的、新近转型的公司,它真的不认识,而且不认识也敢报名字。
这篇文章完整记录我们如何给这台引擎装上“搜索的眼睛”:Brave Search API + Kimi(Moonshot)搜索 API 双搜索腿的接入全过程、踩过的每一个坑、以及双腿上线后的 A/B 实测数据。文末会诚实地盘点我们还缺什么、下一步升级什么。
一、架构:搜索腿在整条流水线里的位置
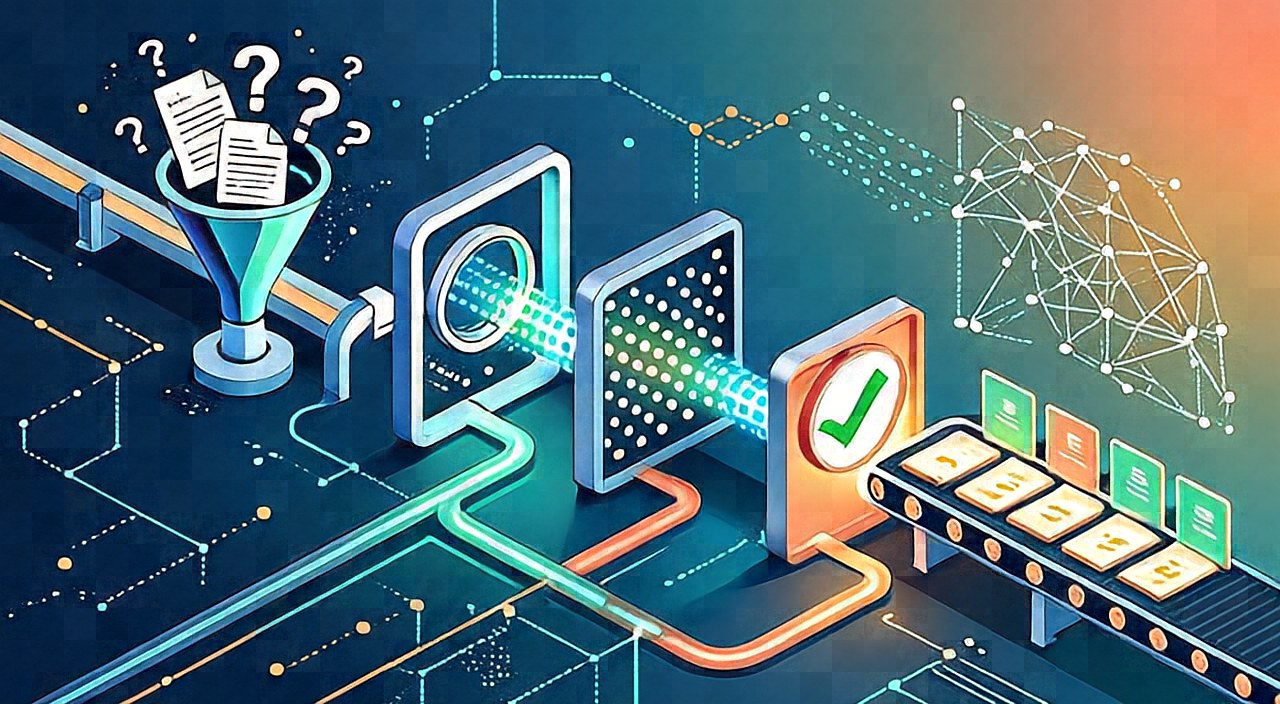
先给全景。一条“目标发现”run 的完整链路是:
ICP 描述(自然语言)
   │
   ├─ ① LLM 生成结构化核验条款(哪些是 required 一票否决项)
   │
   ├─ ② 种子生成 = 三路并行
   │     · LLM 知识种子(模型认知里的知名玩家)
   │     · Brave 搜索腿 ─┐  两条腿共享同一组 LLM 生成的
   │     · Kimi 搜索腿  ─┘  3 条英文搜索查询,省一半成本
   │
   ├─ ③ 域名清洗:剔除目录站/测评聚合站/SERP 噪音
   ├─ ④ DNS 预检:NXDOMAIN 的幻觉域名当场击毙
   │
   ├─ ⑤ 逐家核验:抓取公司官网 → LLM 对照条款打分
   │     required 缺失 → 一票否决(veto),绝不入表
   │
   ├─ ⑥ found < 阈值 → 补种子轮(再来一轮搜索腿+LLM)
   │
   └─ ⑦ 入表 → 批量富集(联系方式/可触达度)→ CRM 自动分层 A/B/C
搜索腿的职责边界非常克制:只负责“找得多”,不负责“判得准”。所有召回的种子,不管来自哪个引擎,一律要过第⑤关的官网取证 + 一票否决。这条纪律是整条流水线敢于放开召回的前提——宁可多花几次抓取,也绝不让幻觉污染数据库。
两个细节值得说:
- 补种子轮:主 run 种子不足时,先跑纯 LLM 加量轮(成本 20 秒、$0.003),不够再跑“LLM+搜索腿”混合轮(成本 90 秒、+3 次搜索调用)。成本分级,把贵的刀留给难啃的利基。
- 重试轮:核验中途如果域名大批解析失败(网络抖动),整轮自动重来一次,避免把网络故障误判成“这家公司不存在”。
二、Brave Search 腿:配置全过程
2.1 注册与取 key
- https://api.search.brave.com 注册开发者账号(支持 Google/GitHub 一键登录)
- 后台 Data Plans → AI 订阅计划(2024 年 10 月后的新制,不是老的按次付费制,别找错地方):Free / Base 每 GB 20 刀 / Pro 每 GB 36 刀,超量部分按 GB 计(1 次 Web Search ≈ 1KB 量级)
- 订阅 Free($0),API Keys → Create key,命名如“console-brave”
- 立刻在 Billing 里把 Free credits 月额度设为 $5(Prepaid 模式),防超支——免费额度内的调用不消耗这个余额,纯保险
拿到的是一个全大写字母的 BSA... key。
2.2 调用骨架(Node 环境)
async function braveQuery(q) {
  const r = await execFileCurl(
    '-s -m 12 --proxy http://127.0.0.1:<proxy-port> ' +
    '-H "X-Subscription-Token: ' + key + '" ' +
    '-H "Accept: application/json" ' +
    '"https://api.search.brave.com/res/v1/web/search?q=' + enc(q) + '&count=15"'
  );
  return (JSON.parse(r).web?.results || []).map(x => ({
    url: x.url, title: x.title
  }));
}
⚠ 这里埋着本次接入最狠的一个坑:在部分机房/家庭宽带出口环境里,Node 内置 fetch 的 DNS 解析会被本地网络环境污染(解析到错误的 IP 或黑洞),而同机身的 curl 因为走系统代理/远程 DNS 完全正常。症状是“接口永远超时”,而 console.log 打出来的 URL 看起来完全正确。
排了半小时的雷,结论:对海外 API 的调用腿,用 execFile curl + 显式 --proxy,别迷信 Node fetch。 一行 spawn('curl', [...]) 的改造让接口从 60 秒超时变成 6 秒返回 5 条结果。
2.3 节流
Brave 免费档限 1 请求/秒。三条查询必须串行 + sleep 1.2s。写进代码里当纪律,别指望调用方自觉。
三、Kimi(Moonshot)搜索腿:配置全过程
3.1 一个容易站错队的坑
Moonshot 的国内站(platform.moonshot.cn)和国际站(platform.moonshot.ai)是两套完全独立的账号、充值和 API key 体系。在 .cn 后台创建的 key 拿去调 .ai 的接口,只会得到 401。我们的 key 建在 .ai(新加坡主体),所以:
- 充值:.ai 后台支持银行卡 / USDT(TRC20),最低 $1
- 模型调用和搜索调用共用同一个余额
3.2 文档骗人现场:参数名
官方文档示例写的是 query,实际服务端要的是 text_query:
# 文档示例(错)→ 400 invalid_request: query is not supported
{"query": "...", "search_type": "web-search-prime"}

# 真实可用(对)→ 200
curl -s https://api.moonshot.ai/v1/tools/search \
  -H "Authorization: Bearer $KEY" -H "Content-Type: application/json" \
  -d '{"text_query": "EU furniture importer", "type": "search-basic", "max_result_len": 4000}'
经验:第三方 API 以真实 400 报错为准,文档只是参考。 用报错信息里的 “text_query is required” 反推参数名,五分钟搞定;信文档则原地打转半小时。
响应结构:data[0].web_results[],每条带 title / url / snippet / icon。计费 $0.002/次成功搜索,失败不计费——按我们的用量(每次 run 3 条查询),$0.006 约等于免费。
3.3 一个彩蛋:官方文档可以整篇抓走
Moonshot 文档站在 URL 后面加 .md 直接吐干净 Markdown(如 .../docs/api/tools.md),比网页解析友好十倍。做文档站的公司都该学学。
四、双腿并行合并:实现要点
// 主 run 与补种子轮共用同一段接线
const qs = await searchQueries(icp, criteria);   // LLM 生成 3 条英文查询
let legs = [];
if (hasBrave() || hasKimi()) {
  emitStage('search');                            // 前端进度条点亮"🔎 双腿检索中"
  legs = await Promise.all([
    hasBrave() ? braveLeg(icp, crits, 10, null, qs) : Promise.resolve([]),
    hasKimi()  ? kimiLeg (icp, crits, 10, null, qs) : Promise.resolve([]),
  ]);
}
// 三路种子按 host 去重合并,一起送进核验队列
seeds = dedupeByHost([...llmSeeds, ...mergeSeedsByHost(legs)]);
设计取舍:
- 同一组查询喂两条腿:Brave 和 Kimi 用的是 LLM 生成的同一份 3 条查询,不是各生成各的——查询质量由模型统一负责,引擎差异留给引擎本身。成本固定为 3×$0.002,而不是翻倍。
- 互补而不是二选一:A/B 实测两家的结果集重叠度远低于预期(不同索引、不同爬虫),合并召回显著大于单腿。
- host 级去重:同一域名带不同路径的结果(官网首页/list/faq)合并为一条,不浪费核验配额。
顺手的产品原则:能 UI 化就别让人碰命令行
两条腿的 key 都收进控制台的「设置 → 🔎 搜索腿」卡片:粘贴即存(服务端写入加密配置 + .env 镜像双持久化),旁边的 ⚡测试Brave / ⚡测试Kimi 按钮各打一次真实 API 调用——成功绿标回显,失败直接带出上游报错原文。部署之后再也没有登过一次服务器。
五、A/B 实测:数据不会说谎
同一份 ICP(欧盟/海湾家具进口经销商)、同一组核验条款、同一套流水线,唯一变量是种子来源:
| 轮次 | 种子来源 | found | 幻觉域名 | 备注 |
|---|---|---|---|---|
| 第一轮 | 纯 LLM | 0 | 3 个(被 DNS 预检击毙) | 模型“白眼的” |
| 第二轮 | + Brave 单腿 | 3 | 0 | 召回破冰 |
| 第三轮 | + Brave & Kimi 双腿 | 9 | 0 | 3 倍于单腿 |
双腿轮拿到的 9 家(全部为可公开查证的知名进口/零售企业):Möbel Höffner(德)、Kwantum(荷兰)、JYSK(丹麦)、Danube Home(阿联酋)、Eijerkamp(荷兰)、ebarza(德国)、WS Living(家居买手零售)、Crate & Barrel UAE、CB2 UAE。
精度没有为召回让路:该轮 46 个候选里,一票否决闸门正确拒掉了 16 个——7 家“无进口业务证据”、6 家“官网抓取失败”、3 家“纯直销品牌”。抽查被拒名单,判罚全部合理(比如两个海湾高端直销品牌确实不做进口分销)。
9/9 家自动完成富集入池并分层:可触达度最高的 JYSK(32 分)/CB2 UAE/Danube Home 进 B 级培育池,其余 C 级暂缓——全程无人工干预。
成本合计:每次 run ≈ 3 次 Kimi 调用($0.006)+ 3 次 Brave 调用(免费额度内)+ 若干次 LLM token。把“找到 9 家真客户”的价格打到了两分钱级别,这在按条计费的线索服务商时代是不可想象的(同类 B2B 线索数据库单条联系方式 API 报价普遍 $1-2)。
六、这两条腿到底在为外贸企业出海赋能什么
摊开说,我认为价值不在“多了个搜索接口”,而在四个角度:
① 把“陌生市场”变成“有名单的市场”。 中小外贸企业出海最难的第一步不是开发信写不好,而是根本不知道该找谁。传统解法要么砸钱买线索库(贵、旧、不垂直),要么人肉 Google(慢、看运气)。搜索腿 + LLM 核验的组合,等于给每个客户配了一个“不会累、自带业务判断力的展会调研员”——你说清楚要什么样的进口商,几分钟后名单带着证据链躺在你面前。
② 长尾召回,这是买来的数据库给不了的。 垂直市场(比如“进口中国软体家具的荷兰中小经销商”)里最有价值的往往不是头部大牌——头部早就被同行开发烂了——而是那批有名有姓、规模合适、没人搭理的腰部公司。搜索引擎恰好是全网腰部公司最好的免费索引。双腿合并进一步把索引的盲区压低。
③ 证据链带来可信度,可信度带来自动化。 每家入表的公司都带着“官网原文摘录 + 条款比对理由”,业务同事不用重新调研就能判断真假,也才敢把后面的富集、分层、触达交给机器。没有证据链的 AI 名单只能当参考,有证据链的 AI 名单才能进流水线。 这是我们从 found=0 的教训里换来的最重要认知。
④ 成本结构决定了“人人可用”。 一次完整的目标发现 ≈ 几分钱 + 几分钟机器时间。传统服务商报价做一单垂直线索要几百上千元,我们把同等质量的持续获客做成了月成本可忽略的基础设施——对小企业,“可持续地小规模高频次找客户”第一次成为可能。
七、我们还缺什么(诚实盘点)
短板 1:核验证据只有官网一个信源。 现在的链路是“抓官网 → 读条款”,遇到两类公司会失灵:官网做得像直销的批发商(信息不透明),以及压根没有现代官网的老派进口商(恰恰是很多欧洲中型经销商的真实画像)。改进:引入 Companies House(英国免费 API 已接)+ 海关数据 + LinkedIn 公开主页(人工核验清单模式,不碰爬虫红线)做交叉佐证。
短板 2:SERP 噪音仍有漏网。 两条腿都返回过“Top 10 Best Furniture Shops…”这类榜单页 URL,虽然会被聚合站过滤器或否决闸门拦下,但每次漏网都要白烧一次抓取+核验的配额。改进:在清洗层加“标题模式预过滤”(listicle/榜单/对比句式直接丢弃),并持续用否决日志反哺过滤词表。
短板 3:Brave 单点依赖 + 出口环境。 搜索腿强依赖代理出口稳定性(就是那个 fetch/curl DNS 坑的根源),Brave 免费档 1qps 也限制了并发规模。改进:给 Brave 腿做双 key 轮换池;查询结果落缓存表(24h TTL),同 ICP 重跑不重复计费;引擎层抽象出适配器接口,接入第三个引擎零改动。
短板 4:语言与区域覆盖偏科。 查询生成默认英文,对德语/法语/阿语市场够用——因为 LLM 生成的英文查询也能召回本地站——但对非英语系小语种利基,本地语言的搜索词召回率会更高。改进:让 LLM 按 ICP 目标市场自动输出一组本地语言查询。
短板 5:验证环节是漏斗最大损耗。 双腿轮里 46 进 9,最大的拒因之一是“官网抓取失败”(超时/反爬/Cloudflare)。有些被拒的公司其实是合格线索,只是网站难抓。改进:抓取层加重试+简化渲染降级(移动版/AMP 页),对反复抓不通的站点走 SERP 摘要兜底核验并明确标注“证据强度:摘要级”。
八、结语
从 found=0 到 found=9,中间隔的不是更贵的模型,而是一次架构自省:把“知道”和“判断”拆开,让搜索引擎负责知道,让 LLM 负责判断,让否决闸门和证据链为两者之间的信任背书。
两条搜索腿总共花了我们一个下午接入、两分钱跑通验证,但它把整台获客机器从“闭眼背书”变成了“睁眼干活”。对做出海 AI 工具的同行者,这是我今年性价比最高的一次工程投入,推荐你也在自己的 pipeline 里装上。
本文所有数据均来自生产环境真实 run 记录,公司名单均为可公开查证的进口/零售企业;API key 与内部基础设施细节已脱敏。