一夜把 125B 本地大模型挂进桌面数字人:完整实操、十个坑与调通记录
摘要:在 24GB 显存的工作站上,把 125B 量化大模型(IQ3_S)部署为本地服务,挂载给桌面数字人当”大脑”,并让本地 agent 接入同一个模型。本文完整记录安装、28.8GB 断点续传、显存交接、语音链路排错、启动器修复的全过程,附十个真实踩坑与对应解法。所有端口、路径、主机名均为脱敏占位,不含任何真实凭据。
一、目标架构
硬件是一台 24GB 显存的笔记本工作站,软件栈分四层:
- Electron 透明悬浮伴侣——桌面数字人,不遮挡办公,支持三态显示;
- Python FastAPI 本地后端(端口
8890)——管 SSE 聊天流、TTS 语音合成、STT 语音识别; - 本地大模型 serve(OpenAI 兼容端点
19099)——125B IQ3_S 量化,带视觉塔; - 本地 agent 框架——与数字人共享同一个大脑。
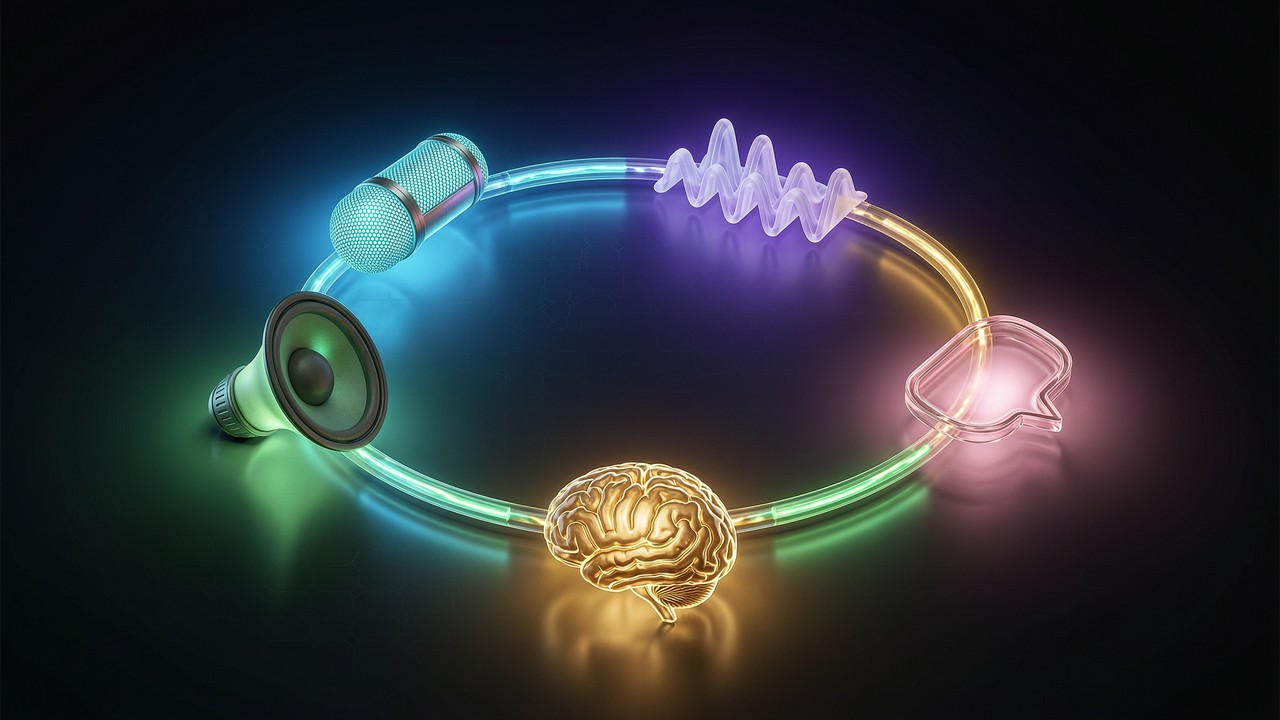
语音闭环链路:用户说话 → 麦克风录音 → STT 转文 → 大模型生成 → 分句 TTS → 播放,同时文字流气泡上屏。
二、模型部署阶段
2.1 安装器初始化
模型发行包提供 setup 脚本,按”家族 + 量化档 + 端口”三要素初始化:
python setup.py --family qwen --model IQ3_S --context 32768 --vision yes \
  --gguf-dir 'X:\models\dir' --data-dir 'X:\data\dir' --port 19099 --no-start --yes
产出四件套:启动脚本(run-<quant>.bat)、推理引擎(engine/<infer>.exe)、视觉塔(vision/<infer>-vision.exe)、多 token 预测草稿(MTP)校验。--no-start 只装不启,避免安装阶段就抢显存。
2.2 权重下载:28.8GB 的断点续传
模型权重切成 72 个分片,总量 28.8GB。直连源站时进度条卡死——用 du 双采样间隔 10 秒对比字节数,确认零增长(不能信 UI 进度条)。自写加固下载器:
socket timeout 150s+ HTTPRange断点续传,单片 12 次重试;- 主源不通自动切双镜像源轮询;
- 分片级
.done标记,拼装阶段按 manifest 逐字节验收。
最终换镜像源后,剩余 11GB 用时 5.5 分钟拉完——前期排障才是大头。
2.3 启动与验收
python serve/api_server.py --engine <infer> --config model.json --port 19099
加载约 1 分钟。验收四连:
curl http://127.0.0.1:19099/health        # status: ok, max_context, images:true
curl http://127.0.0.1:19099/v1/models     # 取模型名
POST /v1/chat/completions  {"enable_thinking": false, ...}   # 非空 content
2.4 性能实测
125B IQ3_S 在 24G 显存上稳定 31~38 t/s,推理、中英双语、视觉三关全过。旧 27B(同 24G)约 36 t/s——量化档够用时,125B 的智力增益是白赚的。
三、挂载数字人大脑
3.1 后端配置切换
后端配置文件(app.json)的 llm_base 指向新大脑:
{ "llm_base": "http://127.0.0.1:19099/v1" }
切换前先备份旧配置(app.json.bak-oldbrain),保留一键回滚。
3.2 显存交接与回滚
旧大脑(27B llama-server)必须先停再起——24G 显存装不下两个。交接验收看显存数字变化:23GB → 4.2GB → 21.3GB(旧脑退出 → 新脑加载前 → 新脑就绪)。回滚路径:还原旧配置 + 重启旧 serve,两分钟回到昨天。
3.3 一键启动器(含大脑自检)
把启动收敛成一个 bat:探测 19099 → 没活就拉起大脑 → 每 5 秒轮询 health → 就绪后再启动 Electron → Electron 内部自管后端(8890)。三层全部幂等:大脑已在线跳过、端口占用复用、重复双击被单实例锁拦截。
3.4 agent 框架接入
OpenAI 兼容自定义 provider:base URL http://127.0.0.1:19099/v1、模型名从 /v1/models 核对、API key 留空(serve 无鉴权)。接入踩了两道硬门槛:
- agent 要求上下文 ≥64K:把 serve 的
--max-context从 32768 改 65536(配置 JSON 内,重启生效); - agent 会把
max_tokens设成整个上下文窗口,serve 对”prompt+输出>上下文”严格 400 拒绝、从不截断 → serve 必须加--fit-max-tokens(自动收缩到剩余空间)。两处要同步写进启动器,否则下次开机又翻车。
四、语音链路全链路验收
验收方法:不信任 UI,拿真数据走完整闭环。启动 Electron 带 CDP 调试口(19333),脚本驱动五步:
- 调后端 TTS 合成一段真人声(模拟用户说话);
- 转 48kHz WAV 注入 renderer 的伪麦克风(getUserMedia 劫持);
- 点麦克风按钮 → 录音 → 提交
/stt; - 喂大脑 → SSE 回复气泡;
- 自动播报 + 检查录音状态归零。
首轮实测:STT 恒返回空文本 "text":""——语音会话根本没跑通(详见坑 #3)。
五、踩坑日志(十坑十解)
| # | 症状 | 根因 | 解法 |
|---|---|---|---|
| 1 | setup 报 [X] missing \d\models\... |
git-bash 的 /d/... 路径被 Windows 程序当字面量 |
参数一律传盘符原生路径 'X:\...' |
| 2 | 大文件下载进度条冻结 | 直连源站被网络策略卡死 | du 双采样实锤零增长;加固下载器 + 换镜像源 |
| 3 | STT 永远返回空文本 | faster-whisper 强制假设 16kHz;Chrome 默认 48k 录音,后端读 wav header 却不重采样 → 音频被当 3 倍慢放,VAD 全滤 | /stt 加 rate != 16000 线性插值重采样(numpy),一处修复全客户端兼容 |
| 4 | 终端中文全是 σñºΦäæ 乱码 |
bat 用 UTF-8 写,cmd 按 OEM 码页逐字节执行 | bat 第二行 chcp 65001;乱码串按 CP437→UTF-8 反解可还原原文验证 |
| 5 | 直连新大脑 content:null |
thinking 模型把答案全写进 reasoning_content |
请求带 enable_thinking:false;后端转发层已内置,裸测勿绕过后端 |
| 6 | agent 首测 400:prompt+max tokens exceeds context |
agent 用整窗当 max_tokens,serve 严格不截断 | serve 加 --fit-max-tokens;同步更新启动器 |
| 7 | 重启电脑后后端 8890 起不来 | 开机竞态:Electron 抢在大脑就绪前启动,后端 bind 失败退出且无重试 | 启动器先等大脑再拉 Electron;main.js 配置残缺时与默认值合并兜底 |
| 8 | 旧大脑退出日志惊现 Errno 10048 |
重复启动的后端撞已健康后端的端口,正常拒绑 | 判据四条:窗口数=1、health ok、旧端口无监听、显存归属正确 → 全过即忽略 |
| 9 | 抠图素材发边残留暖晕(边缘 R-B 偏 +23.5) | 抠图把暖色背景腌进发丝边缘 | 九版迭代:保亮度削暖 + 绿系深层参照门控,只洗发边;最终边缘带 R-B +2.7,亮度 38.71→38.70 保真 |
| 10 | 多次后台通知报 exit 127/0 | 历史重复进程撞单实例锁正常自杀 | 见坑 #8 四判据,一律归档不响应 |
六、调通后的终态验收
全部用可复核的硬数据说话:
- 模型:
/healthstatus:ok,上下文 65536,视觉开启; - 后端:
/healthllm/tts/stt三真,llm_base指向新大脑; - 文字会话:Enter 发送 → 大脑回复气泡,人设语气完整;
- 语音会话:TTS 真人声 → 伪麦克风 → 录音 → STT 正确识别原句 → 大脑 → 自动播报,闭环无残留(
recLeft:false micRec:false); - agent 对话:端到端含工具调用,引擎日志可见 20K+ prompt 由 125B 亲自处理;
- 桌面:单窗口贴右缘,透明空区像素差 0.0,拖拽缩放 / 双击隐藏 / 迷你头像完整人脸全部 CDP 实测通过。
七、日常启动与回滚
- 开机:双击一键 bat(大脑自检 → Electron → 后端全自动);
- 只启大脑:单独 bat 或引擎原生脚本;
- 回滚旧大脑:还原
app.json备份 + 重启旧 serve;素材有.bak-日期快照,配置有.bak-oldbrain。
八、小结
这单活真正的工作量不在”装模型”,而在验收体系的建立:进度条会撒谎、UI 会卡死、日志有残影、健康接口不证明语义正确。所有结论都要求可复核的硬数据——字节采样、像素统计、CDP 真实事件、CP437 反解、三变体隔离实验。十个坑里只有 1 个是模型本身的问题,其余九个全是集成层的:编码、采样率、启动顺序、上下文预算、路径方言。本地大模型落地,拼的就是集成工程的细节。