一、症状:所有人都是 A 级 = 没有人是 A 级
系统的线索打分链路原本长这样:
LLM 对每条 criteria 输出 score(0-100) + reasoning + confidence(0-1)
→ 每条 criteria 带 weight
→ matchScore = Σ(score × weight × confidence) / Σweight
公式本身教科书级别,但两个隐藏阀门把梯度碾平了:
- 置信度地板:
effConf = max(0.4, confidence)——LLM 说”我不确定”,代码替它把不确定强行抬到四成确定。再叠加 LLM 打分天然聚集在 70-95 区间(讨好性偏置),任何一家公司都能攒出 ≥70 的总分。 - 没有负反馈:系统只会”加分”。宜家(IKEA)和一个真正该开发的中型进口商,在这套公式下拿分能力几乎相同——因为”证据充分”本身就在给巨头送分。
审计数据:72 家,66 家 ≥70 分(92%)。用户视角:打开名单,排序从上到下一片红,谁先联系?不知道。评分系统退化成了安慰剂。
二、三刀改造
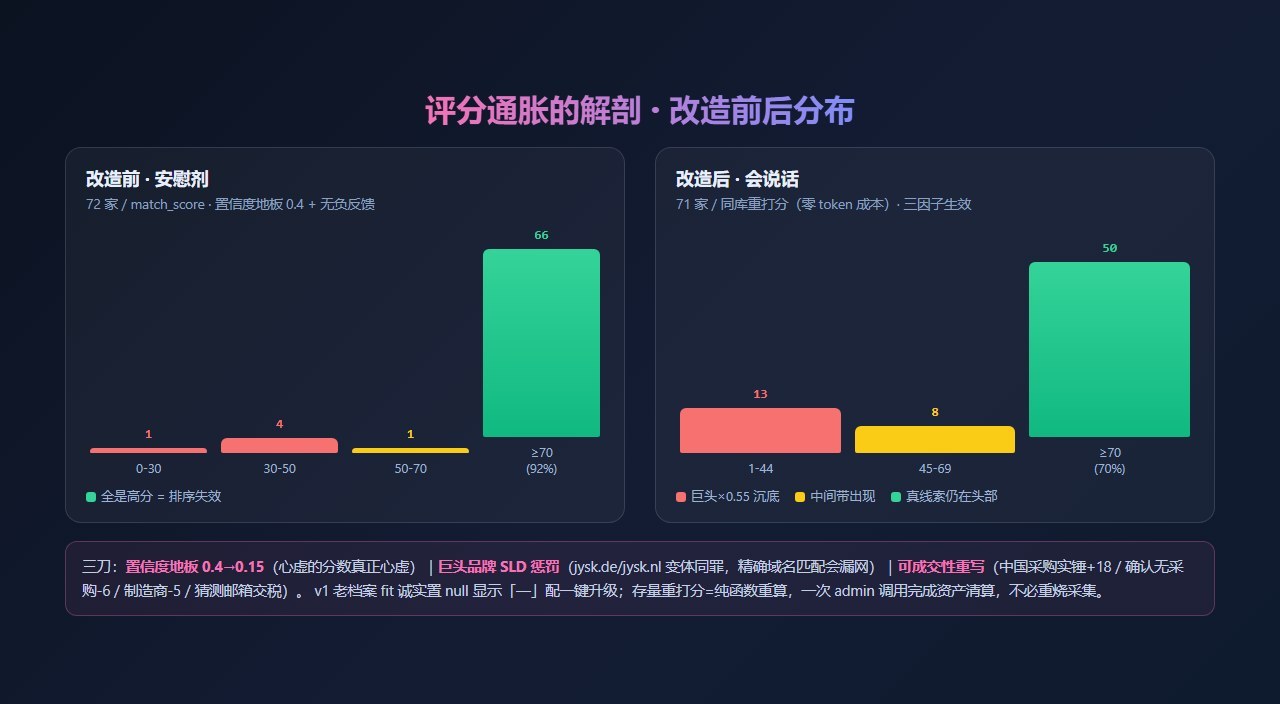
第一刀:拆掉置信度地板
max(0.4, conf) → max(0.15, conf)。留 0.15 而不是 0,是为了给”完全没证据但 LLM 勉强给了判断”的项保留最低权重的信息量,同时让”心虚的分数”真正心虚起来。
第二刀:巨头惩罚(可成交性先验)
出口获客业务的真相:跨国巨头是”看得见吃不着”的典型。它们有全球采购部,但供应商准入是另一套完全不同的游戏(招标、验厂、账期、认证),冷邮件路径的成交概率≈0。让它们霸占高分榜前排,就是在教用户浪费子弹。
实现:
MEGA 名单(品牌注册域名集)→ 命中则 score × 0.55
这里有个花了真金白银才学到的坑:精确域名匹配会被 ccTLD 变体漏网。第一轮上线后复查,IKEA 主域被正确压到 22-47 分,但另一家北欧家居巨头的 jysk.de、jysk.nl 仍以 85/86 分雄踞榜首——名单里只有 jysk.com/jysk.dk。修法是把匹配从”整域查表”改成品牌 SLD 匹配:提取二级域名(处理 co.uk 这类两段 ccTLD 的坑),命中品牌名即打巨头旗。跨国企业官网域名体系再花哨,品牌词本身是改不掉的。
第三刀:重写”可成交性”子分
主分之外,深度背调档案另有一个 trade-fit 子分(0-100),这一版把业务常识硬编码进去:
基础 50
+ 贸易角色先验:进口商/零售 +16,品牌方 +10,货运代理 -8
+ 中国采购证据:direct(海关实锤) +18 / indirect +8 / none -6
- 制造商身份 -5(工厂要的是设备,不是你的货)
+ 买入信号 ×3(上限 12)
- 招聘贸易岗 +6
+ 已验证真实邮箱 +8 / 仅猜测邮箱 -4 / 无邮箱 -8
+ 多源证据(≥2) +6 / 单源 -2
- 薄档案惩罚 -8
两个设计原则:
- 业务常识优先于统计直觉:
china_sourcing=none(背调确认这家不从中国采购)是负信号,直接扣分,而不是”中性 0″。这条规则上线后,一家被确认无中国采购的美国品牌商从”看起来不错”的池子沉到 11 分——正确。 - 猜测信息要交税:pattern 拼出来的”可能邮箱”拿 +0 甚至负分,只有官网实锤+验证通过的才加分。评分体系要诚实地奖励证据质量,而不是奖励信息密度。
一个语义 bug:v1 档案的 fit 分数去哪了
存量数据里有大量旧版(v1)背调档案,它们缺新信号字段。第一反应是”按现有字段照算”,算出来一片 45-64 的窄簇——等于用新公式给旧数据发了假通行证。
正解是语义诚实:v1 档案的 fit_score 返回 null,前端显示”—”,并配一个”旧版档案”徽标和一键升级到新版背调的入口(复用整条计费链)。没有可靠证据时,宁可不给分。
但这里埋出了一个上线后被回归测试抓到的真 bug(后面细说):判据依赖 research_depth 字段,而赋值语句写在了调用之后。
三、存量重打分:不重跑背调的资产清算
改完公式,72 家 + 44 份档案的存量分数怎么办?重新背调 = 烧 LLM token + 烧积分 + 半小时。但这次改造的三个因子——置信度、巨头旗、可成交性重算——全部是纯函数,原料都躺在数据库里:
POST /api/admin/rescore
→ 遍历 items:criteria_summary(含每条 confidence)× criteria weights 重算 matchScore
→ enrichment 档案重算 tradeFitScore
→ 一次性 UPDATE 回库
一次调用完成全库资产清算,零 token 消耗。上线后先 sqlite3 .backup 做了库级备份,这是任何全表 UPDATE 前的仪式。
改造前后对比(真实数据):
| 指标 | 改造前 | 改造后 |
|---|---|---|
| ≥70 分占比 | 92%(66/72) | 70%(50/71,清洗孤儿后) |
| 45-69 中间带 | 1 家 | 8 家 |
| <45 低分段 | 5 家 | 13 家 |
| TOP10 巨头数量 | 2 家常驻榜首 | 0(宜家/北欧家居系全部沉底 22-52) |
| v2 档案 fit 跨度 | 45-64 窄簇 | 7→63 全量程 |
榜首换成了德国的中型家居连锁和荷兰大众零售商——评分系统第一次说出了它真正的意见。
四、回归测试抓到的两个真 bug
- 顺序敏感 bug(我们埋的):fit 计算函数加了”v1 档案返回 null”的判据后,开始依赖
research_depth字段;但档案组装代码里 fit 计算那行写在research_depth赋值之前——于是所有新跑的深度背调 fit 全变 null,而单元测试式的抽查(只看”有没有分”)全绿。最终是老 E2E 套件里三条fit_score present断言红的那天下午被抓出来,交换两行修复。教训:给纯函数加”语义判据”时,判据依赖的字段就是新的输入契约,调用点顺序要重审。 - 孤儿数据放大:重打分后 items 从 72 涨到 114——技能采集腿是异步的,名单删除后它还在往库里插。这些孤儿行污染了分布统计(51 个高分里混进测试数据)。写了一个级联清理脚本(先备份,删 items 前先确认其 webset 已不存在,再清关联 runs/搜索历史),清完”孤儿=0″。分布式异步写入 + 级联删除 = 孤儿是必然产物,每轮测试收尾都要把孤儿计数当作验收项。
五、经验清单
- 上线任何打分系统之前,先画它的分布直方图。 一个只有”高分”的系统没有排序价值,评分系统的 KPI 是方差,不是均值。
- 置信度地板是通胀泵——你给 LLM 的”不确定”兜多少底,用户就会对榜单失多少信。
- 可成交性要先验地写进分数:巨头的品牌域名按 SLD 匹配(警惕 ccTLD 变体),”确认不做某事”是负信号,猜测信息要交税。
- 评分公式重构的最大红利是存量重算:只要因子是纯函数、原料在库,一次 admin 端点就能完成资产清算,不必重烧采集成本。
- 给旧数据打
null比给旧数据打假分更贵,但也更对——用户会原谅”没有分”,不会原谅”错的分”。 - 回归套件是最后防线:两个上线 bug 都不是人眼看出来的,是”早就该红”的老断言红的。老测试的价值在改动之后才显现。